第14回 台本:なぜ、チームを助けるエンジニアが評価されにくいのか
図1は放送時の説明資料(Slide 01)です。
今週、AIを使って小さな機能修正を二十件出した人と、チーム全員の足を止めていた厄介な障害の原因を一つ取り除いた人。あなたなら、どちらを高く評価しますか。
今日は、仕事の件数やAIの利用量を数えるほど、チームを助ける大事な仕事が見えなくなるという、二〇二六年の評価制度の落とし穴を考えます。
先に私の答えを言うと、件数や消費量だけでは絶対に選べません。その仕事で誰が助かり、どんな手戻りや待ち時間が減ったのか。
そこまで見ないと、目先で数字を稼いだ人を褒めてしまい、裏で組織を支えている人を潰してしまいます。
こんにちは、限界コンサルおじです。いつもは海外の最新テクノロジー動向を深掘りしていますが、今回は少し視点を変えて、海外のソフトウェア開発組織を取材する一次資料と、二〇二六年の最新調査レポートを入り口に、エンジニアの評価と生産性測定を徹底的に深掘りします。
エンジニアの方はもちろん、目標管理や人事評価に悩むすべてのマネージャーや企画職の方にも、そのまま自分の職場に置き換えて聞いていただける内容です。
前提の整理と全体の見取り図(何をすべきかの全体像)
図2は放送時の説明資料(Slide 02)です。
まず、今回の土台になる二つの情報源を紹介します。一つ目は、ニュースレターのザ・プラグマティック・エンジニアです。
書き手のゲルゲイ・オロスは、配車サービスのウーバーや、通話サービスのスカイプなどでエンジニアやマネージャーとして働いた経歴を持っています。著者紹介:S4
このニュースレターで二〇二四年一月に公開された、開発生産性の測定事例という記事があります。ゲルゲイと、開発者体験プラットフォームのディーエックスを率いるアビ・ノダの共著で、Googleやリンクトイン、ペロトンなど十七社の生産性測定チームに取材した記事です。
なお透明性のためにお伝えすると、ゲルゲイはアビ・ノダの企業への投資家であり助言者でもあることを記事内で開示しています。記事の位置づけ:S1
そしてもう一つの柱が、それから二年が経った二〇二六年現在の最新状況です。Google・クラウドの調査機関であるドーラが二〇二六年三月と六月に公開した公式インサイトレポート、さらにザ・プラグマティック・エンジニアが二〇二六年四月と七月に報じた、AIエージェント時代のトークン消費とコードレビュー負荷の調査です。
2026年DORA分析:S5 2026年トークン消費問題:S6
なぜ二〇二四年の基礎調査と、二〇二六年の最新レポートを並べるのか。それは、AIがコードを猛烈な勢いで書くようになった二〇二六年になって、かつて基礎調査が警告していた「測定と査定を混ぜる危険」が、これまでとは桁違いの規模で爆発しているからです。
今日、番組を通して持ち帰ってほしい区別はたった一つです。人が働きやすくなるための「測定」と、人の給料や昇進を決める「査定」は、目的がまったく違うということです。
この二つを混ぜると、改善のために集めたはずの数字が、いつの間にか社内ランキングの順位表に変わり、現場の協力関係が壊れます。まず第1章で、二〇二六年の開発現場で起きている異変から見ていきましょう。
第1章:海外一次データが示す現場の変化
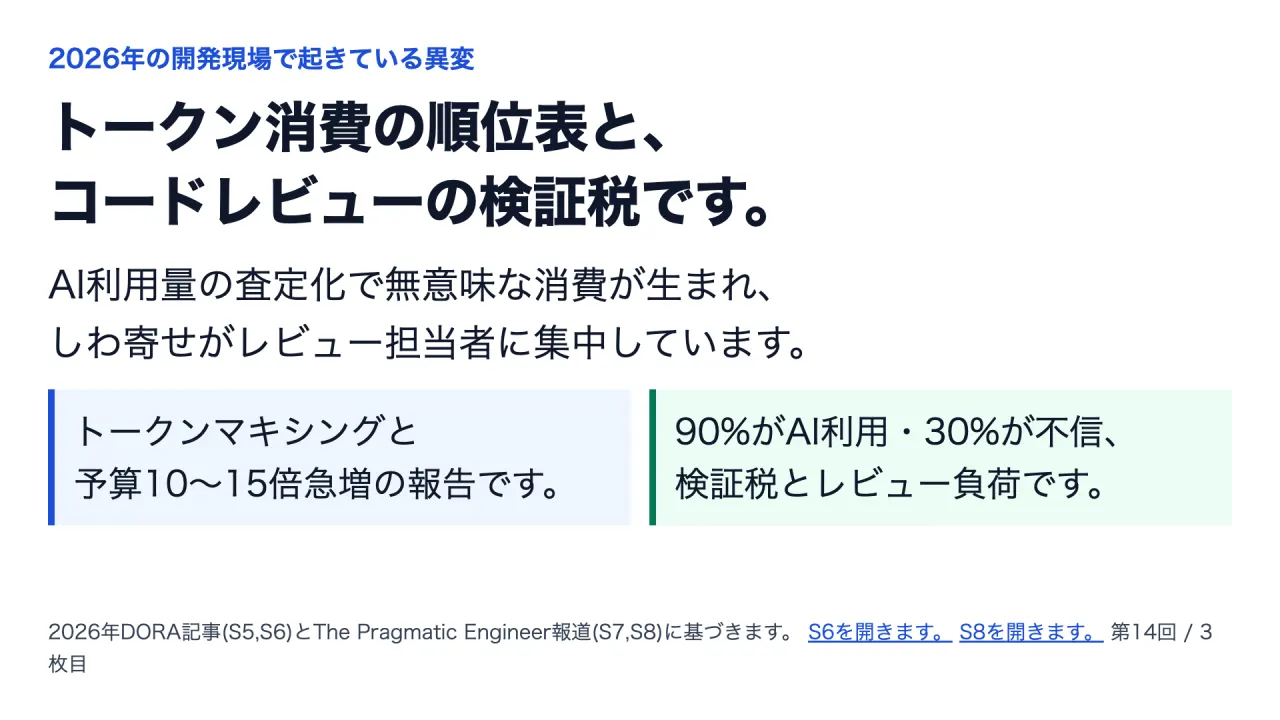
図3は放送時の説明資料(Slide 03)です。
そもそも、エンジニアの評価をめぐる空気はここ数年で大きく揺れ動いてきました。さかのぼれば二〇二三年三月のザ・プラグマティック・エンジニアの記事でも、公開された導入部において、コスト削減の波の中で一部のテック企業で人事評価が厳しくなり、低評価者の退出が起きていると報告されていました。
公開導入部:S2
そこから三年が経った二〇二六年、現場のプレッシャーはどう変わったでしょうか。今、多くの企業で人事評価のシートに新しく加わったのが「AIをどれだけ活用しているか」という項目です。
ザ・プラグマティック・エンジニアが二〇二六年四月に十五社の現場を取材した記事では、今年の人事考課にAI活用度の評価欄が設けられたことで、開発者がとにかくAIを使い倒そうとする強い圧力が生まれていると報告されています。15社取材記事:S7
その結果、二〇二六年の春にシリコンバレーで奇妙な流行語が生まれました。「トークンマキシング」です。
ドーラが二〇二六年六月に公開したレポートによると、競争の激しいテック企業の一部が、社内のリーダーボード、つまり順位表を作って、AIのトークンをどれだけ大量に消費したかを個人別に追跡し、称賛するようになりました。DORAトークンマキシング分析:S6
すると現場のエンジニアはどう動いたか。AIを使っていない時代遅れの人だと思われたくない、あるいは人事評価で不利になりたくないという防衛本能から、自律型AIエージェントを、本番に出すつもりのない無意味なプロジェクトや冗長なタスクで一日中回し続け、個人のトークン消費スコアを人為的に水増しする行動が起きたのです。
DORAトークンマキシング分析:S6
ザ・プラグマティック・エンジニアの取材でも、わずか半年でAIトークンの支出が十倍から十五倍に跳ね上がった企業の事例や、一人の開発者が一日に五百ドル、あるいは一回の長いセッションで千四百ドルものトークンを消費した事例が紹介されています。15社取材記事:S7
これは経済学や組織論で知られる「グッドハートの法則」そのものです。ある指標が目標や人事査定の基準になった瞬間、その指標は良い測定尺度ではなくなる。
かつては「書いたコードの行数」や「コミットの回数」で行われていた見せかけの生産性ゲームが、二〇二六年には「消費したAIトークンの量」に姿を変えて再来しているのです。DORAトークンマキシング分析:S6
しかも、問題は無駄なクラウド費用だけでは終わりません。本当に深刻なのは、AIが大量に吐き出したコードのしわ寄せが、チームの誰に行っているかです。
ドーラが二〇二六年三月に発表したレポートを見てみましょう。このレポートは、約五千人を調査した二〇二五年ドーラレポートと、二〇二五年第3四半期にGoogle社内のソフトウェアエンジニア千百十人から集めた自由記述回答を詳しく分析したものです。
調査では、開発者の九〇パーセントがすでに仕事でAIを使っており、八〇パーセント以上が個人の生産性が上がったと感じています。ところが同時に、約三〇パーセントの開発者は、AIが生成したコードを「ほとんど信頼していない」または「全く信頼していない」と答えています。
DORA 2026年3月分析:S5
ここでドーラが名付けた重要な概念が「検証税」、英語でいうベリフィケーション・タックスです。AIによって最初のコードを書く時間は劇的に減りましたが、節約されたはずの時間は、AIの出力が正しいかを監査し、手直しし、プロンプトを調整する時間にそのまま消えているのです。
DORA 2026年3月分析:S5
さらにこの負担は、コードを書いた本人から、それをチェックするチームの仲間へと転嫁されます。二〇二六年七月のザ・プラグマティック・エンジニアの記事では、二〇二六年一月にオーパス四・五やジーピーティー五・四といった高性能モデルが普及して以降、ソフトウェア開発の最大のボトルネックが「コードを書くこと」から「コードをレビューすること」へ完全に移動したと報じられています。
レビュー負荷増大の報道:S8
書き手はAIを使って巨大な変更を数分で作り、プルリクエストとして提出できます。しかし、それを受け取るシニアエンジニアや仲間は、一見きれいに見えるAIコードの中に潜む微妙なバグや設計のズレを、自分の頭と目を使って一行ずつ確認しなければなりません。
まじめにレビューする人ほどAIが量産した粗雑なコードの束に押しつぶされて疲弊し、逆に疲れた人が「AIの自動チェックが通っているからよし」と中身を見ずに承認スタンプを押せば、今度は本番環境の障害が増える。実際、ドーラの調査でも、AIの導入が進むほど、開発のスループットと同時に「デリバリーの不安定さ」も増加していることが指摘されています。
DORA 2026年3月分析:S5 レビュー負荷増大の報道:S8
考えてみてください。もしあなたの職場で、プルリクエストを出した件数や、消費したトークンの量だけで個人の成績を決めていたらどうなるでしょうか。
第2章:技術的・構造的な仕組みと落とし穴
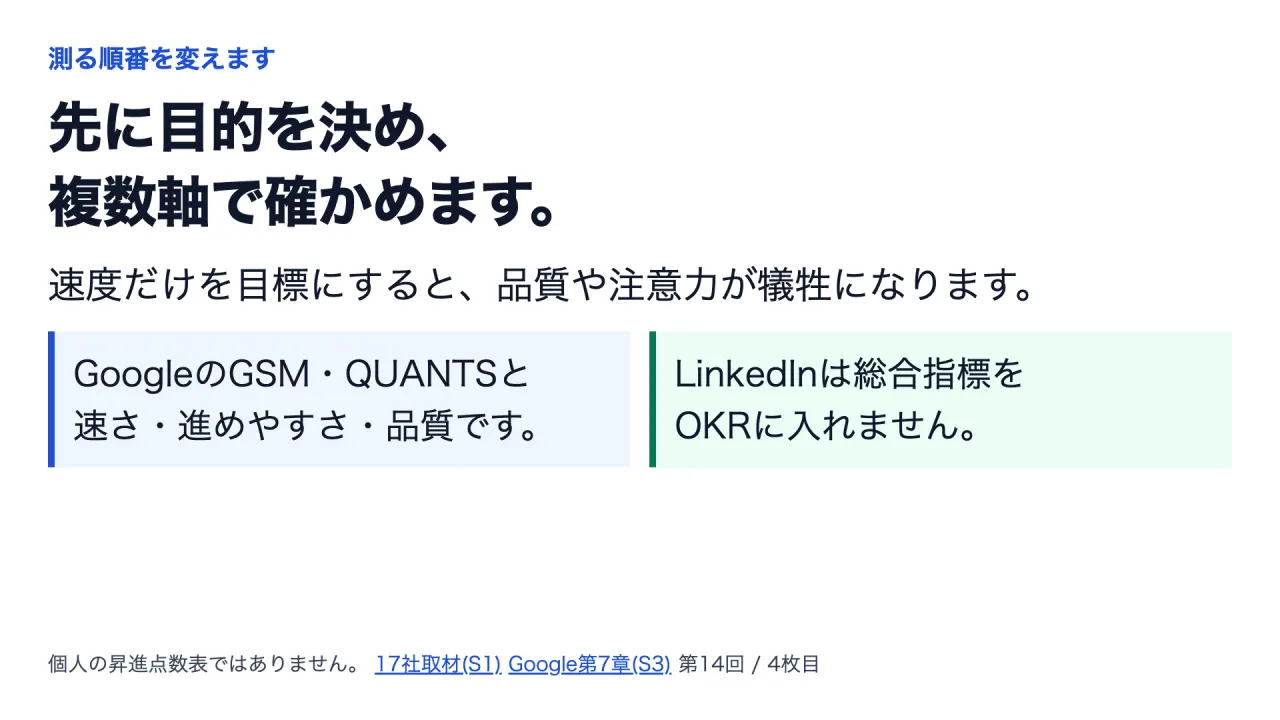
図4は放送時の説明資料(Slide 04)です。
では、先進的な開発組織はどうやってこの罠を避けているのでしょうか。ここで、二〇二四年の十七社取材記事と、Googleのエンジニアリング生産性測定の原典に立ち返ってみましょう。
ここに、AI時代にも全く揺らがない普遍的な原則があります。
第一の原則は、単一の数字で生産性を決めつけず、緊張関係にある複数の軸を同時に見ることです。十七社取材記事の中で、Googleのデベロッパー・インテリジェンス・チームは、ツールやプロセス、チームの生産性を測るときに「スピード」「進めやすさ(イーズ)」「品質(クオリティ)」という三つの次元を必ずセットで見ると説明しています。
3軸の事例:S1
たとえば、先ほどお話ししたコードレビューのプロセスを測るとします。スピードは、レビューが完了するまでにどれくらい時間がかかるか。
進めやすさは、開発者がレビューの仕組みをどれだけ迷わずスムーズに使えるか。そして品質は、レビューからどれだけ有益なフィードバックが得られたかです。
3軸の事例:S1
Googleの技術書『ソフトウェア・エンジニアリング・アット・Google』の第7章では、著者のシエラ・ジャスパンとコリン・グリーンが、このトレードオフを忘れないための五つの構成要素として「クオンツ(QUANTS)」という頭文字を紹介しています。コードの品質、エンジニアの注意力、知的な複雑さ、テンポと速度、そして満足度の五つです。
方法論:S3
著者は本のなかで、とても皮肉でわかりやすい例を挙げています。もしあなたが「コードレビューの速度」だけを極限まで速くしたいなら、方法は簡単です。
コードレビューを完全に廃止してしまえばいいのです。そうすれば待ち時間はゼロになり、速度の指標は過去最高を記録します。
しかし、そんなことをすればコードの品質が崩壊するのは誰の目にも明らかですよね。方法論:S3
二〇二六年の現場でも同じことが起きています。だからこそウーバーのような企業は、単にレビューを急かすのではなく、社内の「コード・インボックス」というツールに「リスク・プロファイル」という機能を組み込み、変更の影響度を推定して、リスクの高い変更に人間の注意力を集中させる工夫をしています。
また、ショッピファイは個人を競わせるAIリーダーボードを廃止し、暴走するエージェントを止めるサーキットブレーカー付きの利用ダッシュボードに切り替えました。セールスフォースも、単なるトークン消費量ではなく、実際に完了した仕事の単位である「エージェンティック・ワーク・ユニット」へ視点を移し、データ基盤企業のスターバーストはトークン最大化を無視して、従来のドーラ指標と障害復旧時間でAIの成果を測っています。
DORAトークンマキシング分析:S6 レビュー負荷増大の報道:S8
第二の原則は、手元にある数えやすい数字から始めず、「目的・兆候・指標」の順番で考えることです。Googleの第7章では、これをゴール・シグナル・メトリクスの頭文字をとって「GSMフレームワーク」と呼んでいます。
方法論:S3
街灯の下で鍵を探す「街灯効果」という言葉があります。夜道で鍵を落とした人が、本当は暗い茂みで落としたのに、「こっちの方が明るいから」という理由で街灯の下ばかり探してしまうという寓話です。
手元で簡単に集計できるコード行数やプルリクエスト件数、トークン消費量ばかりを見るのは、まさにこの街灯の下を探す行為です。方法論:S3
GSMでは、まず測定方法を含まない「目的(ゴール)」を言葉にします。次に、その目的が達成されたら現場にどんな変化が起きるかという「兆候(シグナル)」を考えます。
そして最後に、その兆候を近似できる「指標(メトリクス)」を選びます。しかも、システムログのような定量データと、エンジニアへのアンケートやインタビューという定性データを必ず突き合わせます。
Googleの調査チームは、定量データと定性アンケートが食い違ったとき、間違っているのはたいてい定量データの側だったと明言しています。たとえば自動ツールが裏で勝手に回したビルドまで待ち時間に含めてしまっていたミスに気づけたのは、実際にエンジニアに尋ねたからでした。
方法論:S3
そして同じくらい衝撃的なのが、リンクトインの事例です。十七社取材記事のなかで、リンクトインのシニア・テックリードであるグラント・ジェンクスは、複数の指標をまとめた「開発者体験インデックス」という総合スコアについて、こう語っています。
「私たちはこの総合スコアを時系列で追跡しません。重みづけをいつでも変更する権利を留保していますし、この指標を絶対にOKR、つまり目標管理の数値目標に入れないよう伝えています」と。
事例の要点:S1
Googleの第7章の脚注でも、生産性指標を個人の人事評価やハイパフォーマー・ローパフォーマーの選別に使う誘惑はあるが、それをやればエンジニアは即座に指標をハックし始め、組織全体の改善には二度と使えなくなるとはっきり警告しています。何のために測るのか。
その境界線を守ることがすべての出発点なのです。方法論:S3
第3章:海外ポッドキャストの肉声と実務の壁
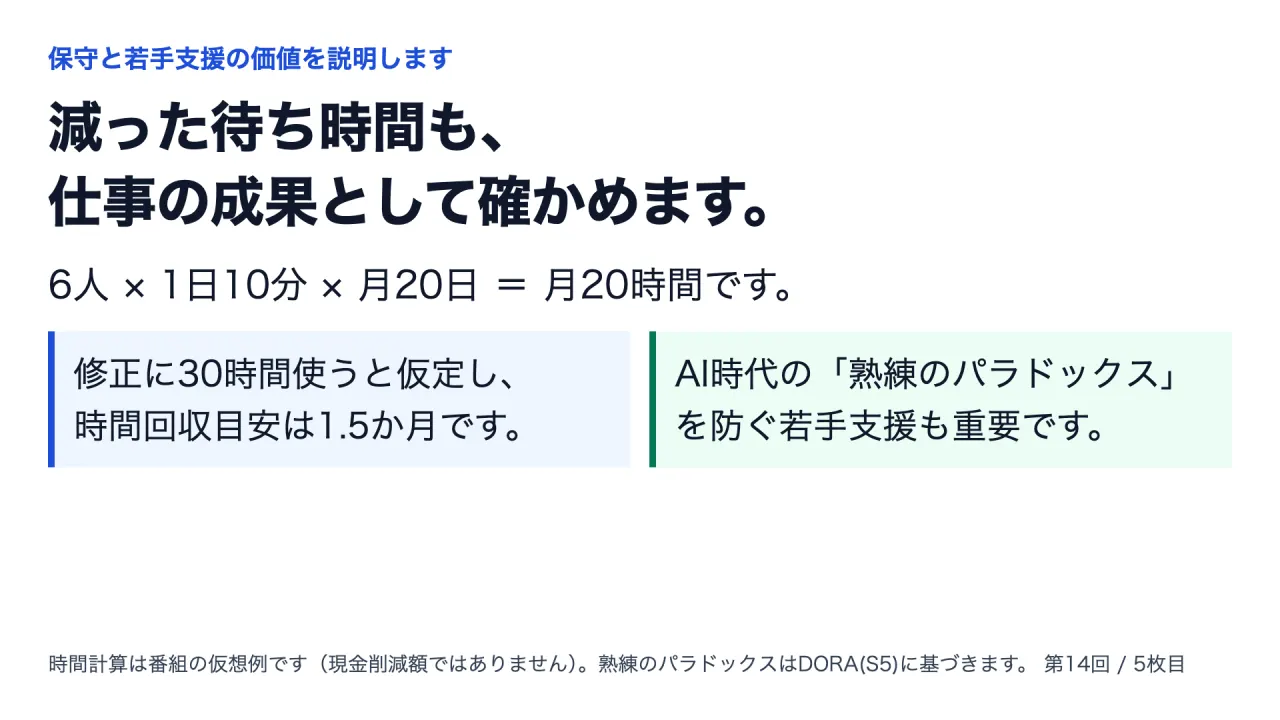
図5は放送時の説明資料(Slide 05)です。
とはいえ、ここで現実的な悩みが残ります。チームの環境改善のための測定と、個人の査定を分けるべきだとしても、現実の会社には半期に一度の評価面談があります。
新しい目玉機能を作った人は成果をアピールしやすい一方で、障害を未然に防いだ人、AIが作った複雑なコードを丁寧にレビューした人、若手の相談に乗った人は、どうやって自分の仕事の価値を説明すればいいのでしょうか。ここからは、一次資料の知見を踏まえた、番組独自の考えと仮想例をお話しします。
冒頭に出した「二十件の小さな修正」と「一件の障害原因の除去」という仮想の例に戻りましょう。一件だから無条件に価値が高い、というわけではありません。
評価の場で必要なのは、その一件の仕事の「ビフォー・アフター」と、「誰のどんな時間を救ったか」をつなぐ具体的な説明です。
仮に、六人の開発チームで、不安定な自動テストがときどき失敗し、毎日一人あたり十分ずつ、確認とやり直しに時間を取られていたとします。月に二十日働くなら、一人あたり月二百分。
六人合計で千二百分、つまり毎月二十時間が、何も生み出さない待ち時間と手戻りに消えている計算になります。
もしあるエンジニアが、自分の機能開発の手を少し止めてでも、この不安定なテストの根本原因を突き止め、三十時間かけて直したとします。すると、チーム全体で毎月二十時間ずつ失われていた手戻りが消えます。
もちろん、ここで誠実な注意が必要です。作業時間が月二十時間減ったからといって、会社から出ていく人件費が現金で二十時間分戻ってくるわけではありません。
あくまで「別の価値ある仕事に使えるはずだった時間を取り戻した」という意味です。また、修正に三十時間かかったなら、作業時間ベースでの回収目安は約一か月半になりますが、今後また別の原因でテストが壊れたり、メンテナンスの手間が発生したりすれば、この数字は変わります。
それでも、「テストを一件直しました」とだけ報告するのと、「六人が毎日十分ずつ失っていた月二十時間の手戻りをなくすために、三十時間かけて根本原因を取り除き、その後二週間で再発はゼロです」と説明するのとでは、上司や評価者が受け取る解像度がまったく違いますよね。
これは二〇二六年のAI時代における「若手への支援」や「コードレビュー」でもまったく同じです。ドーラの二〇二六年三月のレポートでは、「熟練のパラドックス」という深刻な問題が指摘されています。
AIが最初からそれらしいコードを書いてくれるため、若手エンジニアが自分で悩みながら基礎を身につける「生産的な苦労」を飛び越えてしまい、表面的な理解のままスキルが劣化するリスクがあるというのです。あるエンジニアは調査の中で、経験のない領域でAIを使うと「盲人が盲人を導いているような感覚になる」と語っています。
DORA 2026年3月分析:S5
だからこそドーラは、シニアエンジニアがジュニアエンジニアとペアを組み、AIが生成した設計判断を一緒にレビューして深い専門性を守ることを推奨しています。DORA 2026年3月分析:S5
この支援やメンタリングの価値を評価するときも、「何回質問に答えたか」「何枚ドキュメントを書いたか」という件数で数えてはいけません。見るべきなのは、「相談に来た若手が、次は同じ種類の問題を自分で検証して解決できるようになったか」「書いた手順書のおかげで、新しく入ったメンバーが詰まらずに環境構築を終えられたか」という、相手の行動の変化です。
一方で、逆の落とし穴にも触れておきます。「保守やリファクタリング、若手支援なら何でも無条件に高く評価しろ」というのもまた危険です。
誰も触らない古いコードを自己満足でいつまでも綺麗に直し続けたり、顧客に新しい価値を届ける仕事が完全に止まってしまったりしては本末転倒です。新規開発か保守かというラベルで競うのではなく、「今の顧客とチームにとって一番痛いボトルネックはどこで、自分の仕事はそこをどう動かしたのか」という一点に戻って価値を語りたいのです。
第4章:私なりの解釈(何をすればいいか:構造変化の核心)
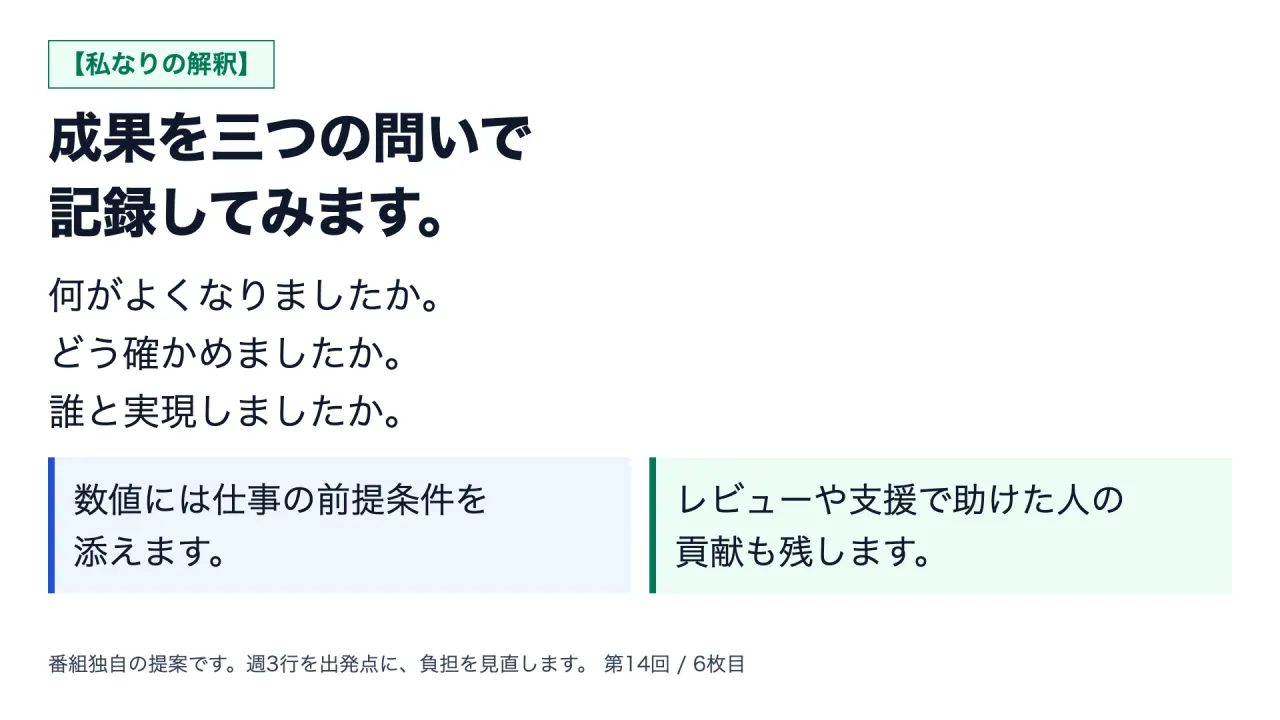
図6は放送時の説明資料(Slide 06)です。
ここからは、日本の職場で明日から実際に試せる、番組独自の具体的な提案です。会社の人事評価制度そのものをいきなり作り直すのは大変ですが、次の評価面談までの「一か月間」だけ、チームの振り返りと成果の記録の書き方を変えてみる実験です。
やり方はシンプルです。成果をメモする欄を、件数ではなく次の「三つの問い」に分けてみてください。
一つ目、何がよくなったか。
二つ目、それをどう確かめたか。
三つ目、誰と一緒に実現したか、あるいは誰を助けたか。この三つです。
たとえば、AIが作ったコードのレビュー待ちや手戻りを減らす仕事をしたとします。
一つ目の「何がよくなったか」には、レビューの待ち時間の短縮や、本番リリース後の手戻りの減少と書きます。
二つ目の「どう確かめたか」には、改善の前後で同じくらいの規模の変更を比べた結果や、実際に変更を出したメンバーからの声を添えます。
そして三つ目の「誰と実現したか」には、一緒にルールを決めてくれた仲間や、逆に自分が設計の相談に乗ってブロックを解消した相手の名前を入れます。
ここで大事なのは、数字の横に必ず「仕事の前提条件」を一言添えることです。たとえば比較した期間にたまたま巨大で複雑な決済システムの変更が集中していたなら、単純に前月とレビュー時間を比べることはできません。
お盆や年末年始でレビュワーが少なかったのかもしれない。だから、都合のよい数字だけを切り取らず、「今回はこういう難しい条件の案件だった」という文脈と、うまくいかなかった点も正直に残します。
それだけで、単なる件数ランキングとは比べものにならないほど、面談の会話が立体的になります。
また、若手を支援した人やコードレビューでチームを支えた人の貢献は、本人だけの自己申告で終わらせず、助けてもらった側からの短い一言で確認できるようにします。ただし、ここで絶対にやってはいけないのは、ピアボーナスや360度評価のために「同僚への長文の推薦状を毎月何通も書かせる」ような重い運用にすることです。
そんなことをすれば、仲間を助けるための時間が、助けたことを証明するための作文の時間に奪われてしまいます。
ですから、記録は「一週間に三行、五分から十分で書けるメモ」から始めるのを強く勧めます。なお、この週三行という数字は、学術研究で証明された黄金律ではなく、現場の記録負担を最小限に抑えるための番組独自の運用案です。
文章にするのが苦手な人が不利にならないよう、書けなかった背景は一対一の面談で上司が聞き取って補う余地も必ず残してください。
【実践・深掘りパート:具体的やり方・試行錯誤の記録】実務で機能する3層ハイブリッド設計
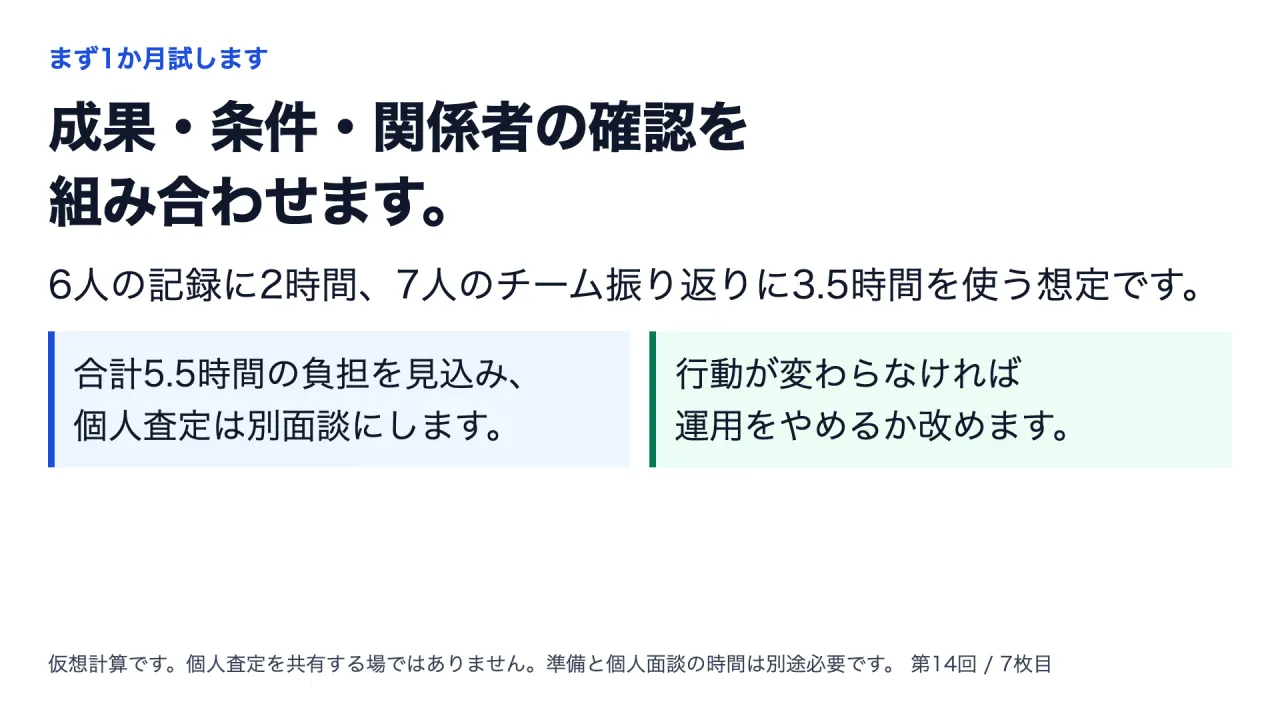
図7は放送時の説明資料(Slide 07)です。
さらにマネージャーやリーダーの方に向けて、制度の選び方を三つの選択肢で比較しておきましょう。
一つ目の選択肢は、プルリクエスト件数やトークン消費量などの「数値ランキング」を中心にする方法です。集計は自動で一瞬で終わりますが、第1章で見たとおり、仕事の難易度や裏方の支援が抜け落ち、数字を稼ぐためのハックが横行するリスクがあります。
二つ目の選択肢は、数字を一切見ずに「上司の主観的な判断」だけを中心にする方法です。現場の事情を汲み取った柔軟な評価ができる反面、どうしても目立つ花形の機能開発や、自己アピールのうまい人が有利になりやすく、評価の納得感が下がるおそれがあります。
そこで私が勧める三つ目の選択肢が、「成果の記録」と「仕事の前提条件」と「関係者による短い確認」を組み合わせる方法です。最終的な評価の責任は上司が持ちますが、その判断を支える根拠として、先ほどの三つの問いのメモを残すのです。
もちろん、Googleの技術書が教えてくれたとおり、どんな測定や記録にも必ずコストがかかります。ここで、この実験にかかる「時間のコスト」を番組独自の仮想計算で見積もってみましょう。
仮に六人のエンジニアがいるチームで、毎週五分ずつ、四週間にわたって三行メモを書くとします。一人あたり月二十分、六人合計で百二十分、つまり二時間です。
そして月末に、メンバー六人とマネージャー一人の合計七人で、三十分だけ「チームの仕組みの改善と、記録のやり方の見直し」を話し合う振り返りを行うとします。七人かける三十分で二百十分、つまり三時間半です。
二つを合わせると、チーム全体で月に五時間半の人の時間を使うことになります。
ここで一つ、非常に重要な運用ルールがあります。この月末の七人の振り返りの場では、「チームの仕事の進め方をどう改善するか」と「記録の負担が重すぎないか」だけを話し合い、個人の査定やランク付けの話は絶対に持ち込まないでください。
個人の評価のすり合わせは、別の1on1面談で扱います。なお、この五時間半という試算には、マネージャーが事前に準備する時間や個別面談の時間は含めていません。
この五時間半は、本来なら開発や顧客対応に使えたはずの貴重な機会費用です。もし一か月試してみて、メモを書く手間ばかり増えて、仕事の優先順位も面談の会話の中身もまったく変わらなかったとしたら、そのやり方は失敗です。
遠慮なくやめるか、さらに軽くするべきです。Googleのトリアージの原則と同じで、「その結果を見て具体的な行動や意思決定が変わらないなら、測る価値はない」からです。
まず一か月だけ試し、メンバー全員に「この記録は役に立ったか」「負担は重すぎなかったか」の両方を聞いてみてください。
そして何より、チームの環境を改善するために集めたアンケートの本音やシステムの数値を、後から黙って個人の減点査定に流用しないこと。「この数字は何のために集め、誰が見て、何には使わないのか」を最初に約束する。
問題を正直に報告した人が損をする職場では、本当のボトルネックは永遠に闇の中に隠れてしまいます。
結論:現場で実際に試してつまずいた箇所・修正手順と明日からの3大アクション
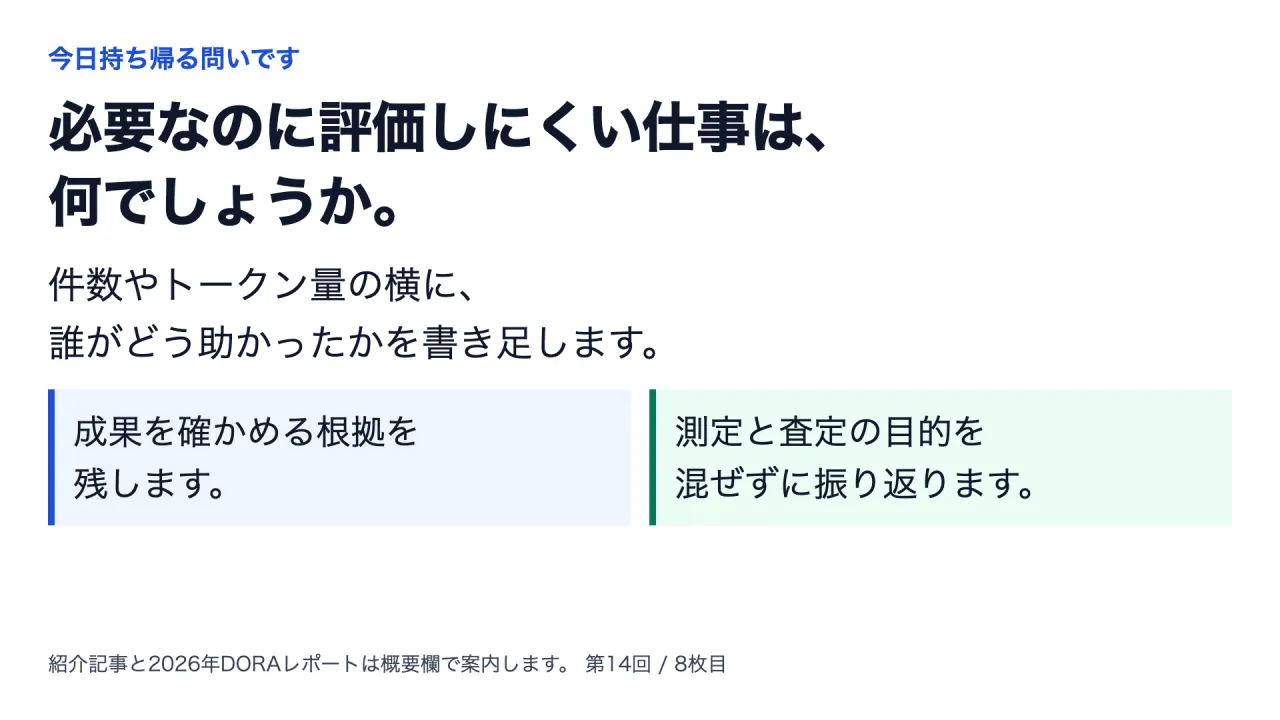
図8は放送時の説明資料(Slide 08)です。
二十件の小さな修正と、一件の障害原因の除去。どちらを評価するかという最初の問いに、もう一度戻ります。
二〇二六年、AIがどれほど高速にコードを書き、どれほど大量のトークンを消費できるようになっても、ソフトウェアが人間のチームで作られ、人間の顧客に使われる以上、この問いへの答えは変わりません。
件数や消費量は、現場で何が起きているかを知るための入り口の手掛かりにはなります。でも、その数字だけで仕事の価値を決めてはいけない。
新規開発も、保守も、肥大化するコードレビューも、そして次の世代を育てる若手への支援も、「何がよくなったか」「どう確かめたか」「誰を助けたか」をセットで見る。そして、職場を働きやすくするための測定と、個人を評価する査定の目的を混ぜない。
これが、今日私が一番お伝えしたかった提案です。
もし明日、職場のチームや上司と一つだけ話すなら、ぜひこう問いかけてみてください。「私たちのチームで、絶対に誰かがやらなきゃいけないのに、今の評価シートには一番書きにくい仕事は何だろう」。
その答えの中にこそ、あなたのチームを本当に支えている仕事と、次の評価面談で光を当てるべき貢献が隠れているはずです。
今日ご紹介したザ・プラグマティック・エンジニアの記事、Googleのエンジニアリング生産性測定の章、そしてドーラの二〇二六年最新インサイトレポートのリンクは、すべて概要欄に載せています。開発の進め方と評価の限界を扱った関連エピソードも、終了画面や概要欄からご覧いただけます。
限界コンサルおじでした。それでは、また。
参照した海外一次資料・出典リンク一覧
- Measuring Developer Productivity: Real-World Examples
- The Scoop #40: Performance reviews, equity refreshers and cost cutting
- Software Engineering at Google, Chapter 7: Measuring Engineering Productivity
- The Pragmatic Engineerの紹介ページ
- DORA | Balancing AI tensions: Moving from AI adoption to effective SDLC use
- DORA | Finding balance in the era of tokenmaxxing
- The Pulse: token spend breaks budgets – what next?
- The Pulse: New trend - concern about massive increase in code review load
この記事は、ポッドキャスト放送回(ep14-engineering-performance)の台本と一次資料をもとに再構成しました(確認日:2026年10月21日)。